 Par Tsuky
Changer de fournisseur de GPU peut coûter davantage en temps d'ingénierie qu'en matériel. Un modèle fonctionne, son environnement de développement est stabilisé, les opérateurs critiques ont été optimisés et les outils de profilage sont maîtrisés. Remplacer les accélérateurs remet potentiellement plusieurs de ces acquis en question.
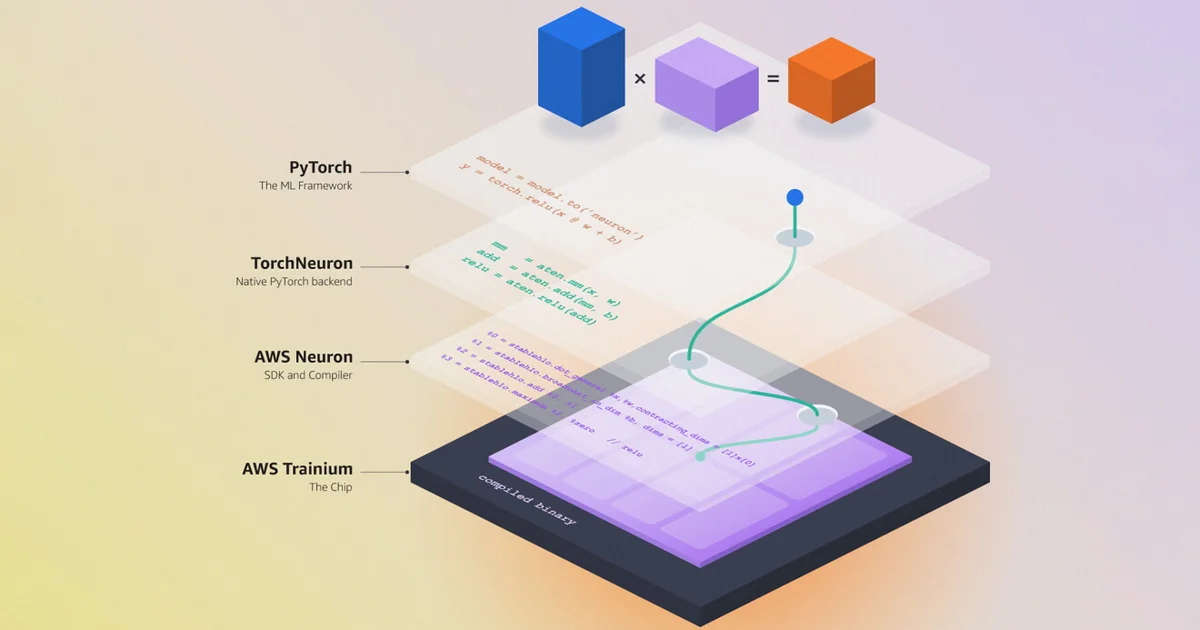
Amazon veut faire disparaître une partie de cette facture avec TorchNeuron. Annoncé le 19 octobre et ouvert en bêta publique le lendemain, ce backend PyTorch permet de sélectionner les puces AWS Trainium comme un périphérique de calcul natif. Le principe affiché est simple : utiliser les API PyTorch habituelles plutôt que réécrire le modèle pour une plateforme propriétaire.
Le projet est distribué en open source sous licence Apache 2.0. Il cible Trainium2 et Trainium3, accessibles à travers les instances EC2 correspondantes. Amazon ne demande donc pas aux développeurs d'adopter un nouveau framework de machine learning. Il cherche au contraire à faire fonctionner celui qu'ils emploient déjà sur son propre matériel.
PyTorch reconnaît désormais Trainium comme un périphérique natif
La démonstration la plus parlante tient dans une instruction : .to('neuron'). Là où un modèle PyTorch est normalement transféré vers un périphérique CUDA, TorchNeuron introduit le périphérique neuron pour exécuter les opérations sur les accélérateurs AWS.
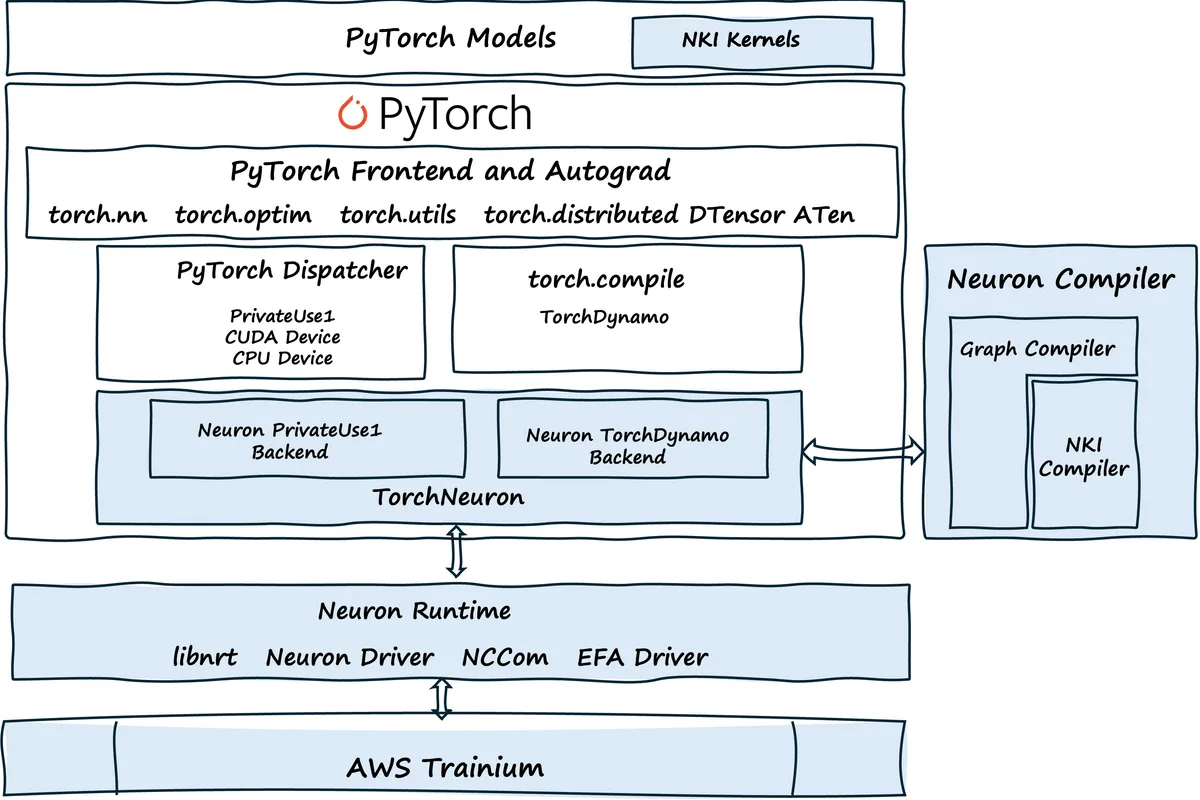
Techniquement, le backend exploite PrivateUse1, un point d'extension officiel de PyTorch destiné aux constructeurs tiers. Le dispatcher du framework peut ainsi transmettre les opérations tensorielles vers les implémentations Neuron sans imposer une nouvelle manière de définir les couches du modèle.
Les API torch.nn, torch.tensor et torch.distributed restent disponibles. Amazon annonce également la prise en charge de torch.compile, du calcul distribué et des outils de profilage intégrés à PyTorch.
L'intérêt est particulièrement évident pendant les phases d'expérimentation. Les équipes qui travaillent avec leurs scripts existants peuvent essayer Trainium sans reconstruire toute leur chaîne logicielle autour d'un SDK spécialisé. En pratique, la quantité de modifications nécessaires dépendra toutefois des opérateurs utilisés, des dépendances externes et des optimisations déjà présentes dans le projet.
AWS propose deux modes principaux. L'exécution eager traite les opérations au fur et à mesure, ce qui conserve les possibilités habituelles de débogage, les points d'arrêt et le contrôle de flux Python. Le mode torch.compile regroupe et optimise des graphes de calcul pour rechercher de meilleures performances en production.
En eager, chaque opération peut générer son propre exécutable Neuron, ce qui entraîne des coûts de compilation et d'exécution. Le mode Adaptive Eager cherche à limiter cette surcharge en fusionnant certaines opérations. Pour les optimisations plus poussées, le Neuron Kernel Interface permet d'écrire des kernels spécialisés.
Une compatibilité native ne veut pas dire que tout fonctionne parfaitement
C'est la réserve qui mérite d'être placée à côté de la promesse commerciale. TorchNeuron est une bêta publique, pas une certification universelle de l'ensemble de l'écosystème PyTorch.
AWS publie une matrice de compatibilité et des résultats de validation des opérateurs. Les développeurs doivent utiliser une version du paquet torch-neuronx correspondant à leur version de PyTorch, sur les systèmes et instances pris en charge.
L'équipe annonce avoir réalisé une campagne de tests couvrant environ 100 000 modèles Hugging Face, représentant selon sa méthode 99,9 % de l'utilisation mesurée par les téléchargements. Les modèles sont exécutés dans des configurations réduites mais représentatives, afin d'observer leur chargement, leurs passages forward et backward, leur compilation et les éventuels replis sur CPU.
Cette couverture est intéressante, mais elle ne démontre pas que 100 000 modèles peuvent tous être entraînés ou servis avec des performances satisfaisantes dans leurs configurations réelles. La méthode évalue d'abord la compatibilité et les chemins d'exécution. AWS reconnaît encore des lacunes et indique travailler à les réduire.
Une application qui dépend de kernels CUDA personnalisés, d'extensions particulières ou de techniques de quantification non prises en charge peut donc nécessiter davantage qu'un changement de périphérique. Même une opération techniquement compatible peut être moins efficace sur un matériel différent.
Amazon facilite l'entrée dans son écosystème. Il ne supprime pas la nécessité de mesurer les performances de chaque charge de travail.
Hugging Face, TorchTitan et vLLM : les intégrations qui comptent
La prise en charge directe du framework ne serait pas suffisante si les bibliothèques utilisées quotidiennement continuaient à supposer la présence de CUDA. Amazon a donc accompagné TorchNeuron d'un travail avec plusieurs projets importants de l'écosystème.
Hugging Face confirme le support natif dans Transformers, Diffusers et Kernels. Cela ouvre la voie à l'utilisation d'une partie des modèles et outils existants sur Trainium sans passer systématiquement par une couche d'adaptation spécifique à AWS.
TorchNeuron s'intègre également à TorchTitan pour l'entraînement distribué, notamment avec Fully Sharded Data Parallelism. Ce mécanisme répartit les paramètres et certains états de l'entraînement afin de réduire les besoins mémoire par accélérateur.
AWS met aussi en avant son travail autour de vLLM, un moteur très utilisé pour servir les grands modèles de langage. Les outils d'inférence constituent une pièce déterminante de l'équation économique : le coût d'exploitation d'un modèle dépend de sa latence, de son débit et de l'utilisation effective des accélérateurs, pas seulement de leur tarif horaire.
L'entreprise indique que plus de trente premiers utilisateurs exploitent déjà TorchNeuron, dans des domaines comme la robotique, les modèles du monde et les applications vocales. Cartesia et le Lieber Institute for Brain Development figurent parmi les exemples présentés publiquement par Amazon.
Il s'agit de références communiquées par AWS, pas d'une étude indépendante établissant un avantage économique identique pour tous les clients.
Pourquoi AWS vise surtout l'avantage logiciel de NVIDIA
NVIDIA ne domine pas uniquement le marché du calcul IA parce que ses accélérateurs sont rapides. CUDA représente aussi des années de développement logiciel, de bibliothèques optimisées et d'intégration aux workflows des équipes de recherche.
Cette situation augmente les coûts de migration. Même lorsqu'un autre constructeur propose un accélérateur compétitif, les entreprises doivent déterminer si leurs modèles, leurs bibliothèques et leurs outils de production fonctionneront correctement dessus.
TorchNeuron cherche à réduire ce verrouillage en s'appuyant sur les interfaces standard de PyTorch. Le choix est significatif : plutôt que demander aux utilisateurs d'abandonner leurs habitudes, AWS adapte son matériel à l'environnement logiciel dominant.
Google suit une logique concurrentielle proche avec ses propres accélérateurs TPU et son effort d'intégration des frameworks populaires. Le marché ne se résume donc plus à une comparaison de puissance de calcul brute.
Il faut cependant distinguer la possibilité d'exécuter du code PyTorch et la disparition de CUDA. Une bibliothèque peut utiliser PyTorch en façade et continuer à dépendre d'opérateurs CUDA spécifiques à l'intérieur. TorchNeuron ne remplace pas automatiquement l'ensemble de cet outillage.
Le développement des composants logiciels natifs, leur maintenance et les résultats de performance obtenus sur de véritables charges de production seront plus révélateurs que la simplicité de la démonstration initiale.
Trainium2 et Trainium3 : le matériel existe, le gain financier reste à mesurer
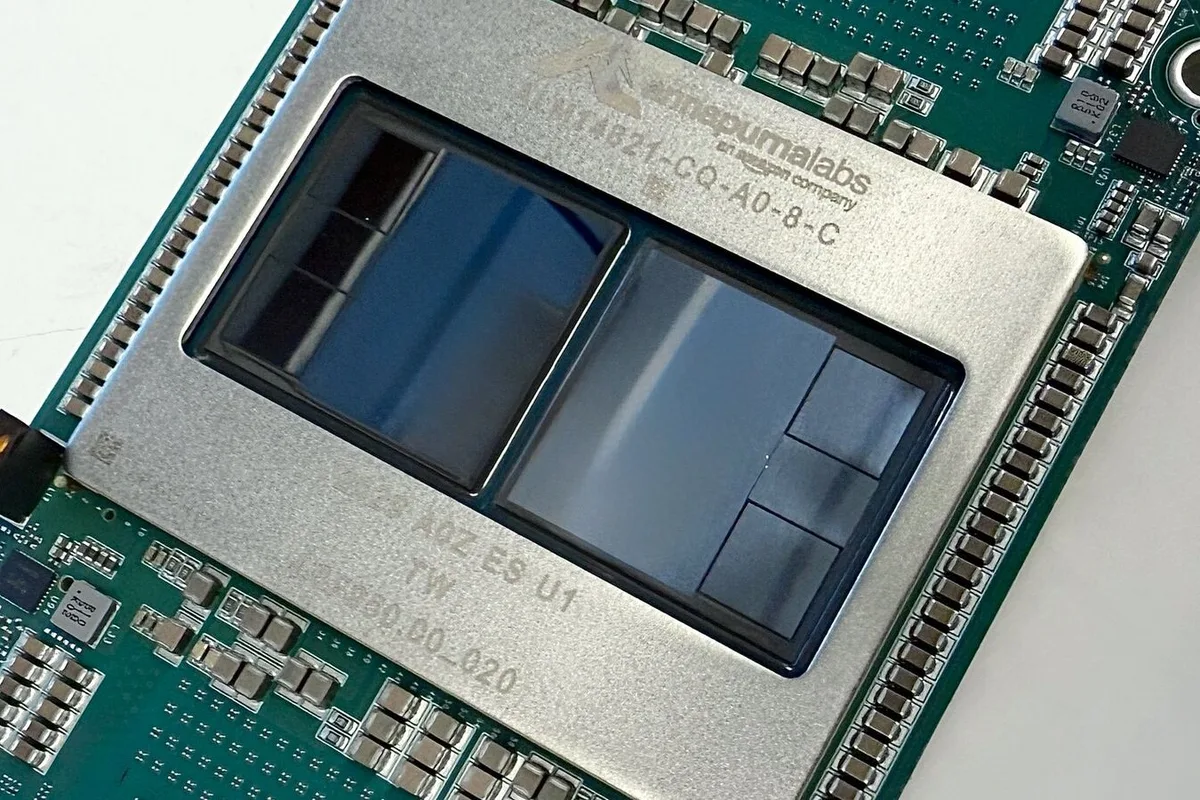
TorchNeuron fonctionne avec les accélérateurs Trainium2 et Trainium3. Ces puces sont conçues par Annapurna Labs, la division de conception de semi-conducteurs d'Amazon, pour les tâches d'entraînement et d'inférence.
L'entreprise peut ainsi proposer une chaîne technique intégrée, depuis la conception du processeur jusqu'à la facturation des instances EC2. Cette intégration lui permet d'adapter le matériel, le compilateur, les communications distribuées et les services cloud aux charges de travail ciblées.
Une démonstration publiée par Amazon montre un script d'entraînement exécuté sur deux types de matériel avec une modification de configuration, en obtenant une évolution comparable de l'apprentissage. Elle illustre la portabilité fonctionnelle du code. Elle ne constitue pas un benchmark général de débit ou de coût par token face aux GPU NVIDIA.
Pour juger une migration, une équipe devra examiner la consommation mémoire, le débit réel, les temps de compilation, la latence d'inférence, la stabilité des bibliothèques et le prix des instances. Les optimisations nécessaires peuvent également représenter plusieurs semaines de travail sur des applications complexes.
Le fait que TorchNeuron soit gratuit et open source ne rend pas gratuite l'utilisation des instances Trainium. La distinction est importante pour les petites entreprises qui cherchent à réduire leurs coûts d'infrastructure.
Une bêta publique déjà disponible, avec des limites documentées
AWS confirme l'ouverture de TorchNeuron en bêta publique le 20 octobre 2026, dans le cadre de la conférence PyTorch North America. Le backend est accessible par le projet torch-neuronx et peut être installé dans un environnement AWS Neuron compatible.
Les notes de version Neuron 2.33.0 détaillent les conditions d'utilisation, les versions prises en charge et les problèmes connus. Les développeurs intéressés disposent également de guides consacrés aux opérateurs, au débogage, à l'entraînement distribué et à la compilation.
Cette disponibilité immédiate distingue TorchNeuron d'une simple annonce de feuille de route. Le logiciel peut déjà être expérimenté sur Trainium2 et Trainium3. En revanche, son statut bêta, ses limitations de compatibilité et l'absence de comparaison indépendante universelle imposent de traiter les promesses d'économies comme des objectifs à vérifier cas par cas.
La véritable avancée d'Amazon se situe pour l'instant dans la réduction de la première barrière : celle qui empêchait de simplement essayer une autre architecture. Il reste ensuite à prouver que chaque modèle fonctionne suffisamment bien pour justifier sa migration.