 Par Adri
L'intelligence artificielle locale change d'échelle. Après avoir cherché à faire fonctionner de petits modèles sur un ordinateur personnel, les développeurs explorent désormais des configurations permettant de réunir plusieurs machines compactes autour d'une même charge de travail.
NVIDIA vient de présenter une démonstration particulièrement ambitieuse de cette approche.
Dans une publication technique datée du 22 octobre 2026, quatre ingénieurs du fabricant détaillent les performances obtenues en connectant jusqu'à huit DGX Spark.
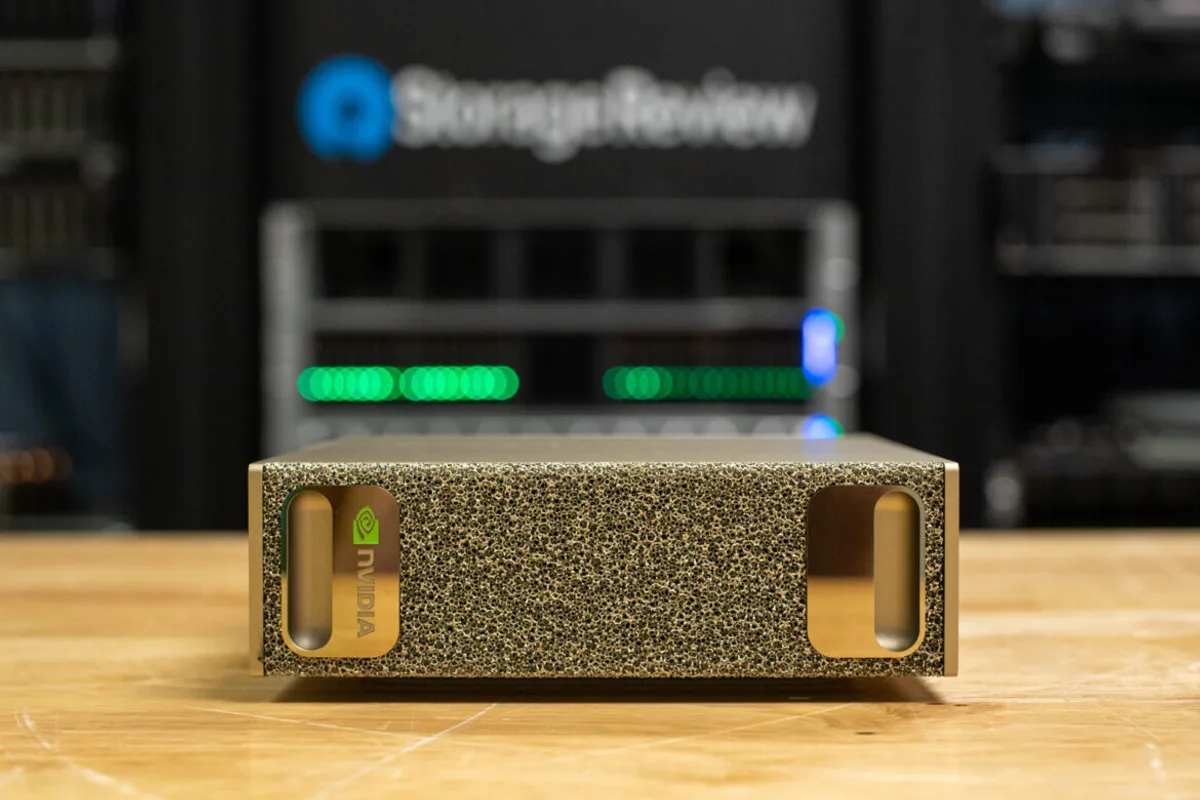
Ces ordinateurs sont conçus pour exécuter des modèles d'IA sur une infrastructure locale, sans dépendre systématiquement d'un service cloud pour chaque requête.
L'intérêt de l'expérience ne réside pas uniquement dans la quantité de mémoire réunie. NVIDIA cherche également à montrer comment cette mémoire peut être exploitée, quelles architectures réseau améliorent les performances et dans quelles situations plusieurs modèles sont plus efficaces qu'un seul.
Les résultats sont intéressants, notamment pour les équipes de développement souhaitant conserver leurs modèles et leurs données sur une infrastructure qu'elles administrent.
Ils doivent néanmoins être examinés dans leur contexte : ce sont des essais réalisés et publiés par NVIDIA sur des charges de travail sélectionnées.
Huit petits ordinateurs pour réunir un téraoctet de mémoire
Chaque DGX Spark de la configuration testée possède 128 Go de mémoire unifiée.
Cette architecture permet au processeur et à l'accélérateur graphique d'accéder à un espace mémoire commun, plutôt que de dépendre exclusivement de la mémoire vidéo dédiée utilisée sur certaines cartes graphiques classiques.
Un système dispose donc de 128 Go. Quatre machines réunissent 512 Go, et huit unités totalisent 1 024 Go, soit environ un téraoctet en unités décimales.
Cette quantité est particulièrement intéressante pour les grands modèles de langage.
Les paramètres d'un modèle doivent pouvoir être stockés, auxquels s'ajoutent les informations nécessaires au fonctionnement du moteur d'inférence et les données utilisées pendant les requêtes.
Un modèle de plusieurs centaines de milliards de paramètres peut donc dépasser la mémoire disponible sur une station de travail traditionnelle.
Répartir ses paramètres sur plusieurs machines permet de franchir cette limite.
Il faut toutefois éviter une confusion : réunir huit capacités mémoire ne transforme pas physiquement huit ordinateurs en un seul GPU.
Les données restent distribuées entre différentes machines, qui doivent communiquer pour exécuter les calculs.
La vitesse de cette communication devient alors déterminante.
GLM 5.3 et ses 753 milliards de paramètres fonctionnent sur le cluster
Pour démontrer l'intérêt de cette capacité, NVIDIA a exécuté le modèle GLM 5.3 développé par Z.ai.
Sa version complète compte 753 milliards de paramètres.
NVIDIA indique avoir utilisé une représentation quantifiée en NVFP4, dont le poids représente environ 470 Go.
La quantification permet de représenter les poids du modèle avec une précision numérique réduite afin de diminuer leurs besoins en mémoire et, selon les opérations, d'accélérer certains calculs.
Elle introduit toutefois des compromis qui peuvent dépendre du modèle et des techniques utilisées.
Le fait qu'un modèle occupe environ 470 Go ne signifie pas qu'une machine disposant exactement de cette quantité de mémoire pourrait nécessairement l'exécuter correctement.
Il faut aussi tenir compte des espaces de travail, du cache des séquences et des ressources utilisées par le logiciel d'inférence.
Sur huit DGX Spark, NVIDIA a mesuré un débit de génération de 31 tokens par seconde pour une requête unique avec GLM 5.3 complet.
Avec quatre requêtes concurrentes, le débit total atteint 51 tokens par seconde. Il monte à 67 tokens par seconde lorsque huit requêtes sont traitées simultanément.
Mais le débit individuel diminue à mesure que la concurrence augmente.
Pour huit requêtes simultanées, NVIDIA rapporte environ 18 tokens par seconde par utilisateur dans le protocole publié.
Ce résultat illustre la différence entre la capacité totale du système et la rapidité ressentie par une personne.
Un serveur peut traiter davantage de travail au total tout en répondant moins vite à chaque utilisateur.
80 tokens par seconde sur GLM 5.3 Flash
NVIDIA présente également des essais réalisés avec GLM 5.3 Flash.
Cette variante atteint environ 80 tokens par seconde dans la démonstration publiée.
Le chiffre est notable pour un système local accueillant un modèle de grande taille.
Mais il ne doit pas être confondu avec les résultats de la version complète de GLM 5.3.
Les modèles, leurs architectures et leurs configurations d'inférence diffèrent.
Il serait donc incorrect d'affirmer que le modèle complet de 753 milliards de paramètres produit systématiquement 80 tokens par seconde sur ce matériel.
La précision importe d'autant plus que les performances d'inférence sont très sensibles à la longueur du contexte, à la concurrence et aux optimisations activées.
Ces premiers résultats prouvent qu'une configuration locale peut exécuter des modèles particulièrement volumineux.
Ils ne prouvent pas qu'elle rivalise économiquement ou techniquement avec toutes les infrastructures cloud destinées aux mêmes modèles.
Les huit machines ne sont pas huit fois plus rapides
Le benchmark le plus révélateur concerne Qwen3.8-27B, un modèle beaucoup plus petit utilisé pour étudier le passage à l'échelle.
NVIDIA a mesuré les performances sur une, deux, quatre et huit machines, en modifiant également la manière de les connecter.
Sur un DGX Spark, le modèle atteint 11,86 tokens par seconde en génération dans le protocole retenu.
Avec deux machines reliées directement, le débit monte à 21,71 tokens par seconde.
Quatre machines connectées en anneau atteignent 32,82 tokens par seconde.
Enfin, huit machines reliées à un commutateur et utilisant une optimisation spécifique atteignent 52,58 tokens par seconde.
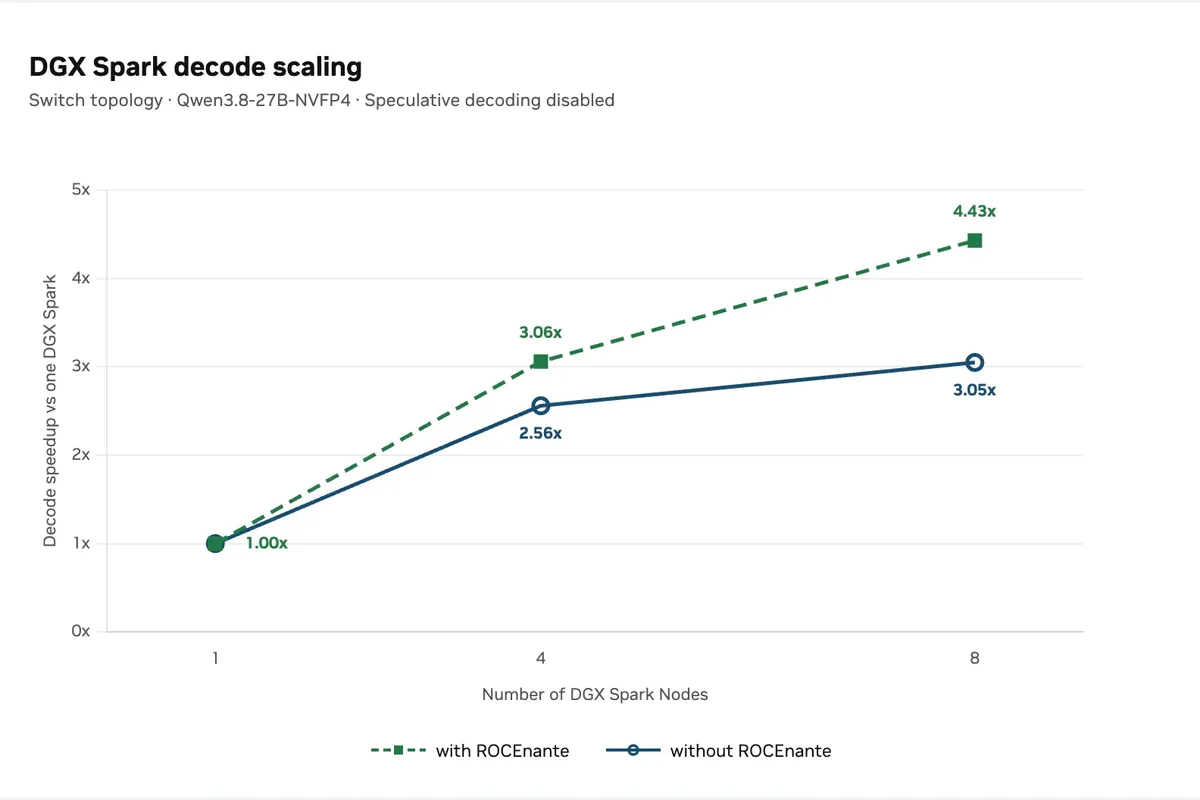
La progression est importante, mais elle représente une accélération de 4,43 fois par rapport à une machine seule.
Huit ordinateurs fournissent donc moins de huit fois les performances sur cette tâche.
L'écart provient notamment des communications nécessaires pour synchroniser les calculs entre plusieurs accélérateurs.
Lorsqu'un modèle est réparti entre plusieurs machines, certaines opérations doivent attendre les résultats produits par d'autres parties du système.
Le réseau devient alors une composante du temps de calcul.
C'est précisément sur ce problème que NVIDIA concentre l'une de ses innovations logicielles.
RoCEnante améliore la communication entre GPU
NVIDIA présente un mécanisme de communication collective appelé RoCEnante.
Le système vise à accélérer certaines opérations de réduction collective, notamment all-reduce, utilisées lorsque plusieurs processeurs doivent réunir des résultats.
Dans une organisation en anneau, les données sont échangées progressivement entre machines voisines.
Cette méthode peut être efficace, mais elle nécessite plusieurs étapes de communication.
RoCEnante adopte une approche différente pour certains petits clusters.
Chaque machine transmet directement ses informations aux autres, puis les résultats sont combinés localement.
L'intérêt est de diminuer le nombre d'étapes de communication pour certaines opérations de petite taille.
Dans le benchmark Qwen3.8-27B sur huit DGX Spark connectés par commutateur, NVIDIA mesure une accélération de 4,43 fois avec RoCEnante, contre 3,05 fois sans cette optimisation.
Cela représente une amélioration relative d'environ 45 % du facteur de passage à l'échelle.
Il ne s'agit pas d'une augmentation de 45 % des performances de toutes les applications tournant sur DGX Spark.
L'amélioration concerne cette configuration, ce modèle et les conditions du test.
Pourquoi RoCEnante ne remplace pas NCCL
Cette méthode présente également des inconvénients.
Lorsque chaque machine transmet directement ses données à toutes les autres, le volume total d'informations échangées peut devenir important.
Plus le cluster grandit, plus cette organisation peut solliciter le réseau.
Les algorithmes classiques d'all-reduce en anneau peuvent conserver un avantage lorsque les messages sont volumineux ou les systèmes plus nombreux.
NVIDIA précise donc que RoCEnante n'a pas vocation à remplacer NCCL, sa bibliothèque de communications collectives.
La nouvelle optimisation est destinée principalement aux petites configurations reliées par commutateur, avec des communications fréquentes et de taille relativement limitée.
Elle est intégrée à FlashInfer, qui peut revenir à NCCL lorsque les conditions nécessaires à son utilisation ne sont pas réunies.
Cette distinction est importante pour les développeurs.
Il n'existe pas une seule architecture réseau optimale pour toutes les tâches d'intelligence artificielle.
Le choix dépend du modèle exécuté, du volume de données échangé, du nombre de machines et des utilisateurs servis simultanément.
Un anneau pour quatre machines, un commutateur pour davantage de flexibilité
NVIDIA détaille également les différences entre plusieurs topologies réseau.
Pour une configuration simple de quatre DGX Spark exécutant un même modèle, une connexion physique en anneau peut être attractive.
Elle évite l'achat d'un commutateur supplémentaire et offre des performances correctes dans le scénario étudié.
La situation change lorsque les machines doivent être réparties entre plusieurs tâches indépendantes.
Un développeur peut vouloir réserver quatre unités à un grand modèle et utiliser les quatre autres pour des assistants spécialisés.
Dans cette organisation, les échanges doivent pouvoir circuler directement entre différents groupes.
Un commutateur devient alors plus adapté.
NVIDIA souligne également que RoCEnante nécessite précisément ce type de connectivité directe entre les nœuds.
Les DGX Spark utilisent leurs interfaces NVIDIA ConnectX-7 et des communications RDMA sur Ethernet convergé pour échanger les données nécessaires.
La qualité de cette interconnexion est essentielle pour éviter que les accélérateurs attendent trop longtemps les résultats des autres machines.
Le cluster n'est donc pas une simple pile de mini-ordinateurs reliés à un réseau domestique ordinaire.
Sa configuration nécessite une infrastructure adaptée et des logiciels capables de gérer le calcul distribué.
Plusieurs petits modèles peuvent faire mieux qu'un grand
L'autre expérimentation importante concerne l'orchestration des agents IA.
NVIDIA utilise NeMo Switchyard pour répartir les requêtes entre plusieurs modèles.
Le principe est simple : toutes les questions ne nécessitent pas le modèle le plus puissant disponible.
Un petit modèle peut suffire pour une tâche facile, tandis qu'un système plus capable sera réservé aux problèmes difficiles.
Dans son prototype, NVIDIA utilise MiniCPM5 2B pour les tâches simples et Qwen3.8 Flash Next pour les requêtes plus complexes.
Un mécanisme de classification détermine le modèle auquel chaque demande doit être transmise.
Les huit machines sont organisées en plusieurs groupes exécutant différentes instances.
NVIDIA décrit notamment une configuration réunissant trois répliques de Qwen utilisant chacune deux DGX Spark, ainsi que deux répliques de MiniCPM fonctionnant chacune sur une machine.
L'ensemble permet de traiter simultanément plusieurs demandes.
Sur un benchmark de 92 cas comprenant des tâches difficiles d'utilisation d'outils, le système de routage obtient une évaluation de 91 sur 100, identique à la configuration reposant uniquement sur Qwen.
Lorsque 75 % des requêtes sont dirigées vers le petit modèle, NVIDIA annonce un débit agrégé multiplié par trois.
Ce résultat illustre une approche potentiellement plus économique que l'utilisation permanente d'un grand modèle.
Mais la qualité dépend du mécanisme de classification.
Si une tâche complexe est orientée vers un modèle trop limité, les résultats peuvent se dégrader.
Le facteur trois correspond donc à un scénario précis, et non à un gain garanti pour tous les agents.
L'entraînement distribué atteint presque l'efficacité théorique
Les essais de NVIDIA ne se limitent pas à l'inférence.
Le fabricant a également entraîné un petit modèle nanochat à partir de zéro sur une à huit machines.
Le modèle comporte environ 896,5 millions de paramètres.
Dans ce scénario, chaque nœud conserve une copie du modèle et participe au traitement de données d'entraînement.
Les machines doivent principalement synchroniser leurs gradients à chaque étape.
Cette organisation est différente de l'inférence d'un très grand modèle réparti sur plusieurs accélérateurs.
Les résultats montrent un passage à l'échelle particulièrement efficace.
Une machine traite 8 741 tokens par seconde.
Deux machines atteignent 17 202 tokens par seconde.
Quatre machines passent à 33 640 tokens par seconde.
Huit machines atteignent 68 079 tokens par seconde.
L'accélération totale atteint 7,79 fois la performance d'une seule unité, soit une efficacité de passage à l'échelle de 97,4 % selon NVIDIA.
Cette efficacité proche de la progression théorique concerne l'entraînement de ce modèle relativement petit.
Elle ne peut pas être appliquée automatiquement aux modèles de plusieurs centaines de milliards de paramètres.
Les besoins de communication et de mémoire sont alors très différents.
Une solution locale ne signifie pas automatiquement une solution moins chère
La possibilité d'exécuter de grands modèles sur son propre matériel présente plusieurs avantages.
Une équipe peut conserver ses données dans son environnement informatique, expérimenter différentes configurations et éviter certains transferts vers des services externes.
Elle peut également disposer d'une capacité de calcul prévisible, sans dépendre directement d'une facturation par token pour chaque exécution locale.
Mais le coût d'un cluster ne se limite pas au prix d'achat des ordinateurs.
Il faut ajouter le réseau, le stockage, la consommation électrique, la maintenance et le temps nécessaire à la configuration.
Huit machines représentent aussi une dépense initiale importante.
Pour une organisation qui utilise occasionnellement de très grands modèles, une infrastructure cloud peut rester plus intéressante.
À l'inverse, une équipe dont les charges de travail sont constantes peut avoir intérêt à disposer de ressources locales.
La comparaison dépend du nombre de tokens traités, du temps d'utilisation, des performances nécessaires et des conditions tarifaires des services alternatifs.
NVIDIA ne publie pas dans son article du 22 octobre une étude complète du coût total de possession comparant son cluster à des serveurs de centre de données équivalents.
Il serait donc prématuré d'affirmer que huit DGX Spark constituent systématiquement une solution moins chère.
Attention à la disponibilité : NVIDIA Sync n'automatise pas encore tout
La démonstration ne signifie pas que les développeurs disposent déjà de toutes les fonctions d'administration promises pour huit machines.
NVIDIA indique que les clusters de huit DGX Spark sont pris en charge en configuration manuelle.
Les expériences publiées prouvent que le constructeur sait faire fonctionner cette architecture dans les conditions testées.
En revanche, la prise en charge complète des clusters de huit unités par NVIDIA Sync Cluster Assistant est annoncée pour la fin de l'année 2026.
Cet outil doit faciliter la détection des machines, leur configuration et la gestion de l'infrastructure.
Le fabricant prévoit également un Model Launcher destiné à simplifier le téléchargement, le lancement et l'utilisation de modèles locaux.
Les deux annonces concernent des fonctions logicielles dont le calendrier doit être distingué de celui des démonstrations techniques.
Le matériel existe et les expérimentations ont été publiées.
Mais l'expérience entièrement simplifiée promise par les futurs outils NVIDIA Sync n'est pas encore disponible dans toutes les configurations décrites.
Une nouvelle version DGX Spark de 64 Go arrive également
En parallèle de ses travaux sur les clusters, NVIDIA développe la gamme DGX Spark.
Le fabricant annonce une version dotée de 64 Go de mémoire unifiée, commercialisée par plusieurs partenaires à partir du 23 octobre.
Le prix de départ annoncé aux États-Unis est de 4 999 dollars.
Cette configuration conserve la plateforme Grace Blackwell GB10 et les logiciels associés.
Elle vise des usages locaux nécessitant moins de mémoire que les systèmes de 128 Go.
Il est important de ne pas confondre cette nouvelle version avec les huit machines utilisées dans les benchmarks du 22 octobre.
Les tests du cluster d'un téraoctet reposent sur huit systèmes de 128 Go.
Huit configurations de 64 Go ne réuniraient que 512 Go de mémoire totale.
Elles ne pourraient donc pas être présentées comme équivalentes au cluster testé par NVIDIA pour GLM 5.3 complet.
Les besoins d'un modèle et les performances obtenues dépendent directement de la configuration matérielle.
Ce que les chiffres montrent vraiment
Le principal résultat de NVIDIA est d'avoir démontré plusieurs formes de calcul distribué sur une infrastructure compacte.
Huit DGX Spark de 128 Go peuvent accueillir le modèle GLM 5.3 complet de 753 milliards de paramètres.
Le fabricant mesure un débit allant jusqu'à 67 tokens par seconde en génération agrégée avec huit requêtes concurrentes sur ce modèle.
Sur Qwen3.8-27B, une configuration optimisée atteint 52,58 tokens par seconde, soit 4,43 fois la performance d'une machine seule.
Pour l'entraînement d'un modèle nanochat beaucoup plus petit, l'accélération atteint 7,79 fois.
Ces trois résultats ne se contredisent pas.
Ils montrent que les caractéristiques d'une tâche déterminent fortement la capacité d'un cluster à profiter de machines supplémentaires.
Une charge dont les communications sont limitées peut obtenir une progression presque linéaire.
Une autre, fortement dépendante des échanges entre accélérateurs, peut voir ses gains limités par le réseau.
La question n'est donc pas simplement de savoir combien de DGX Spark on peut réunir.
Elle consiste à choisir la bonne répartition des modèles, des données et des opérations.
Une étape importante pour l'IA locale, pas la fin des serveurs cloud
La publication du 22 octobre 2026 montre une évolution intéressante du marché.
L'intelligence artificielle locale ne se limite plus aux petits modèles fonctionnant sur un ordinateur isolé.
Des équipes peuvent désormais envisager des infrastructures personnelles ou partagées capables de charger des modèles bien plus volumineux.
Cette capacité pourrait faciliter le développement d'applications spécialisées, les expérimentations sur des données internes et les tests de nouveaux agents.
Mais un cluster compact ne remplace pas automatiquement les capacités d'un grand centre de données.
Les systèmes industriels peuvent disposer d'accélérateurs plus puissants, de réseaux spécialisés et d'architectures mieux adaptées à la production à grande échelle.
Les résultats de NVIDIA doivent donc être vus comme une démonstration d'une nouvelle possibilité technique, et non comme une comparaison universelle gagnée contre le cloud.
L'avenir de ces configurations dépendra autant de leur facilité d'utilisation et de leur coût total que de leurs benchmarks.
La véritable leçon est ailleurs : pour faire progresser l'IA locale, ajouter de la mémoire et des processeurs ne suffit pas. Il faut surtout apprendre à les faire travailler ensemble.