 Par Adri
L'intelligence artificielle générative est souvent racontée à travers la taille de ses modèles, le nombre de GPU nécessaires à leur entraînement ou le coût des centres de données. Pourtant, une difficulté beaucoup moins visible se trouve derrière chaque connexion à ChatGPT : il faut pouvoir accéder rapidement et de manière fiable aux données dont le service a besoin.
Paramètres de compte, préférences, métadonnées, état des applications et informations nécessaires à leurs différentes fonctions : ces données doivent rester disponibles même lorsqu'un très grand nombre de personnes utilisent les produits simultanément.
C'est le rôle de Habitat, la plateforme de stockage développée par OpenAI. Le 23 octobre 2026, trois ingénieurs de l'entreprise, Jon Lee, Hrachya Hakobyan et Chaomin Yu, ont publié une analyse détaillée de son architecture.
Le bilan donne une idée de l'échelle atteinte : plus de 500 pétaoctets de données administrées, des services couvrant 40 régions géographiques et une infrastructure conçue pour répondre aux besoins de plus d'un milliard d'utilisateurs.
Ces chiffres ne décrivent pas seulement une base de données particulièrement volumineuse. Ils montrent surtout ce qui se produit lorsqu'une infrastructure logicielle doit absorber une croissance rapide tout en restant suffisamment simple à utiliser pour ses propres développeurs.
Habitat, la couche de stockage derrière plusieurs produits OpenAI
Habitat n'est pas une application destinée au grand public. Il s'agit d'une plateforme interne qui fournit aux différents produits OpenAI un accès aux données dont ils ont besoin.
Ses clients comprennent ChatGPT, l'API destinée aux développeurs, Codex et plusieurs services internes.
Au lieu de demander à chaque équipe de gérer intégralement sa propre base de données, Habitat propose une couche commune chargée de nombreuses fonctions techniques.
On y trouve notamment le routage des requêtes, les contrôles d'accès, le chiffrement, les politiques de limitation de débit, l'isolation des charges et la gestion de la localisation des données.
L'architecture utilise plusieurs ressources de stockage, dont Azure Cosmos DB, des caches Valkey et des systèmes complémentaires.
La quantité annoncée de 500 pétaoctets correspond à l'ensemble des données prises en charge par cette plateforme. Il serait incorrect d'en déduire que les conversations des utilisateurs représentent à elles seules un tel volume.
Le défi principal consiste à transformer cet ensemble de services en une infrastructure suffisamment fiable pour que les développeurs puissent s'en servir sans devoir comprendre chaque détail de son fonctionnement.
La première difficulté : partager une base de données sans perturber les voisins
Au départ, OpenAI utilisait un conteneur Azure Cosmos DB partagé entre plusieurs applications.
La mutualisation présente un avantage évident : les ressources disponibles peuvent absorber les variations de charge provenant de différents produits.
Un service peu utilisé à un instant donné laisse ainsi de la capacité aux autres.
Mais ce fonctionnement comporte un problème classique des infrastructures mutualisées : le noisy neighbor.
Lorsqu'une application génère une quantité anormalement élevée de requêtes, elle peut utiliser une part disproportionnée des ressources communes.
Les autres applications, pourtant indépendantes, subissent alors des ralentissements.
OpenAI explique avoir rencontré ce problème jusque dans des fonctions particulièrement sensibles, comme les parcours de connexion et d'inscription.
Le phénomène ne se limitait donc pas à une dégradation ponctuelle d'une fonction secondaire. Une charge concentrée sur certaines données pouvait affecter des éléments essentiels du service.
Pourquoi les partitions deviennent un problème à grande échelle
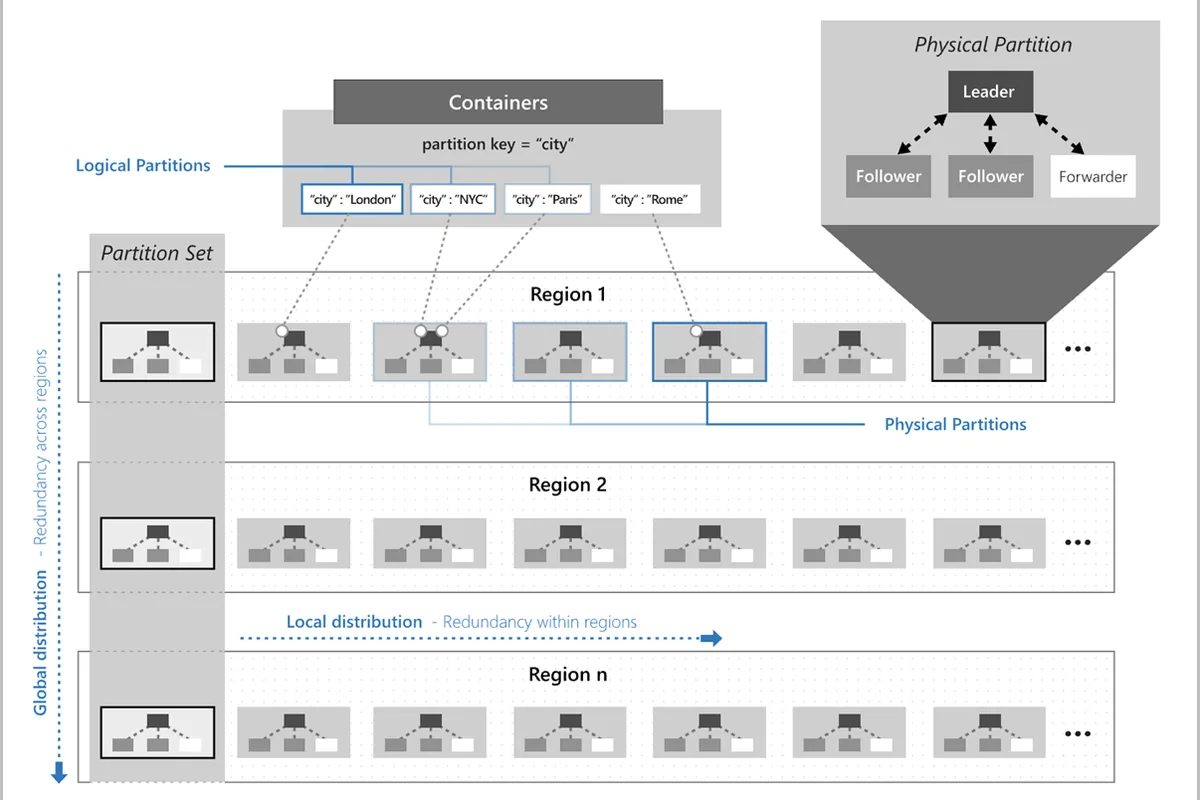
Azure Cosmos DB répartit les données à partir de clés de partition logiques, elles-mêmes associées à des partitions physiques.
Cette organisation permet de distribuer le stockage et le traitement sur plusieurs ressources.
Mais elle crée des limites qu'il faut comprendre lorsque le trafic augmente fortement.
OpenAI explique que certaines applications utilisaient les mêmes clés courantes, par exemple user_id ou workspace_id.
Des charges distinctes pouvaient alors se retrouver en concurrence sur les mêmes limites de débit.
Autre difficulté : les limites de débit ne s'appliquent pas uniquement aux clés logiques. Plusieurs partitions logiques partagent les ressources de partitions physiques.
Une partition physique fortement sollicitée peut donc pénaliser plusieurs ensembles de données qui n'ont pourtant aucun lien fonctionnel.
L'entreprise a également rencontré des partitions dont la capacité effective diminuait à mesure que le stockage augmentait.
Lorsqu'une partition physique est divisée pour accueillir davantage de données, la capacité totale provisionnée peut être répartie entre les nouvelles partitions.
La quantité de stockage augmente, mais le débit disponible par partition peut devenir insuffisant.
Cela produit une situation contre-intuitive : un service peut subir des ralentissements alors même que son nombre de requêtes n'a pas augmenté.
Isoler chaque application semblait résoudre le problème
Pour limiter ces perturbations, OpenAI a commencé à utiliser des conteneurs dédiés pour certaines charges importantes.
L'idée était simple : si une application possède son propre conteneur, elle risque moins de ralentir les autres.
Cette séparation améliore l'isolation et limite l'étendue de certains incidents.
Mais elle introduit une autre difficulté : chaque équipe doit prévoir les ressources nécessaires à son propre service.
Une application qui passe brutalement de quelques requêtes de test à un million de requêtes par seconde exige un dimensionnement radicalement différent.
Dans un grand conteneur partagé, cette croissance peut représenter une fraction relativement limitée de la capacité globale.
Dans un conteneur isolé, elle peut dépasser très largement les ressources initialement prévues.
OpenAI raconte que certaines équipes lançaient de nouvelles fonctionnalités sans avoir correctement anticipé leur consommation.
Les ingénieurs chargés de l'infrastructure devaient alors intervenir en urgence pour augmenter la capacité.
L'isolation améliorait donc la résistance à certains incidents, mais compliquait les lancements et multipliait les tâches opérationnelles.
Retour à la mutualisation, avec de nouvelles règles
La troisième phase de l'évolution de Habitat consiste à revenir vers les conteneurs partagés par défaut.
Cette décision peut sembler paradoxale après les problèmes rencontrés initialement.
La différence vient des mécanismes désormais disponibles pour mieux répartir les ressources.
OpenAI et Microsoft ont travaillé sur une limitation ciblée des clés les plus sollicitées. Le système peut réduire prioritairement le débit d'une charge particulièrement importante avant qu'elle ne pénalise les autres.
Une gestion de qualité de service permet également de distinguer les requêtes critiques des travaux moins urgents.
Les opérations de maintenance ou de traitement en arrière-plan peuvent être limitées avant les requêtes interactives nécessaires aux utilisateurs.
Enfin, Microsoft a développé un mode serverless amélioré permettant, selon OpenAI, à chaque partition physique d'atteindre 10 000 unités de requête par seconde.
Le mécanisme de division des partitions peut également prendre en compte la consommation de ressources, et plus seulement le volume de stockage.
Cette évolution évite de dépendre aussi fortement d'un dimensionnement manuel anticipé.
OpenAI affirme n'avoir connu aucun nouvel incident de provisionnement ou de noisy neighbor pendant les mois suivant ces changements.
Il s'agit d'un retour d'expérience opérationnel de l'entreprise, pas d'une garantie que la plateforme ne rencontrera plus jamais de problème.
Une panne Azure a révélé les limites de l'infrastructure
La publication revient également sur deux incidents survenus fin 2024.
Une panne électrique a d'abord touché la région Azure principale de l'un des grands comptes Cosmos DB utilisés par OpenAI.
Lors de l'opération de basculement vers une autre région, les équipes ont constaté que les comptes les plus volumineux pouvaient nécessiter plusieurs heures pour terminer le processus.
Environ un mois plus tard, le retour vers la région initiale a provoqué un autre incident.
De nombreuses connexions ont été rétablies simultanément, surchargeant une passerelle Azure Cosmos DB.
Une particularité du comportement du client en mode gateway conduisait les applications à renvoyer immédiatement leurs connexions et leurs requêtes vers la région d'origine, alors que seule une partie des partitions physiques avait été transférée.
Pour OpenAI, ces incidents ont montré qu'un service cloud managé ne dispense pas de comprendre ses limites internes.
À une certaine échelle, le client et le fournisseur doivent tester ensemble des scénarios qui ne se présentent pratiquement jamais chez des utilisateurs plus modestes.
OpenAI et Microsoft travaillent désormais plus directement ensemble
Les équipes Habitat et Azure partagent aujourd'hui davantage d'outils opérationnels.
OpenAI décrit des tableaux de bord communs, des tests réalisés sur une infrastructure de taille comparable à la production et des canaux directs entre ingénieurs.
Certaines procédures permettent même aux équipes d'alerter directement leurs homologues, sans passer par les circuits habituels de support.
Cette organisation vise à détecter les problèmes avant qu'ils ne touchent les utilisateurs.
Le plus grand compte Azure Cosmos DB d'OpenAI stocke actuellement plusieurs dizaines de pétaoctets et traite, selon l'entreprise, plus de 20 millions de requêtes par seconde.
À cette échelle, les modifications d'un service managé peuvent nécessiter des tests spécifiques et une coordination permanente.
Le fournisseur cloud n'est plus simplement un prestataire externe qui garantit une capacité théorique. Il devient un partenaire technique directement impliqué dans la stabilité de l'ensemble.
La proximité géographique des données devient un enjeu de performance
Résoudre les problèmes de disponibilité ne suffit pas. Il faut également réduire le temps nécessaire pour récupérer les données.
Une requête exécutée en Europe peut devoir accéder à des informations stockées dans une autre région du monde.
Même si les serveurs sont rapides, la distance ajoute une latence incompressible liée au trajet réseau.
La première réponse consiste à rapprocher les données des zones où elles sont utilisées.
OpenAI possède des comptes Azure Cosmos DB dans différentes régions, notamment pour répondre aux exigences de résidence des données.
Mais la proximité géographique n'est pas toujours possible.
Certaines régions ne disposent pas de suffisamment de capacité de stockage, de puissance électrique ou de refroidissement pour accueillir une copie proportionnelle des données nécessaires.
Il faut donc arbitrer entre utiliser les ressources disponibles pour rapprocher le stockage ou les réserver à davantage de puissance de calcul.
Ce compromis souligne que la performance d'un service mondial n'est pas uniquement un problème logiciel.
Elle dépend aussi de l'implantation physique et de la capacité des centres de données.
Répliquer partout uniquement les données les plus importantes
Une autre stratégie consiste à multiplier les copies de certains ensembles de données.
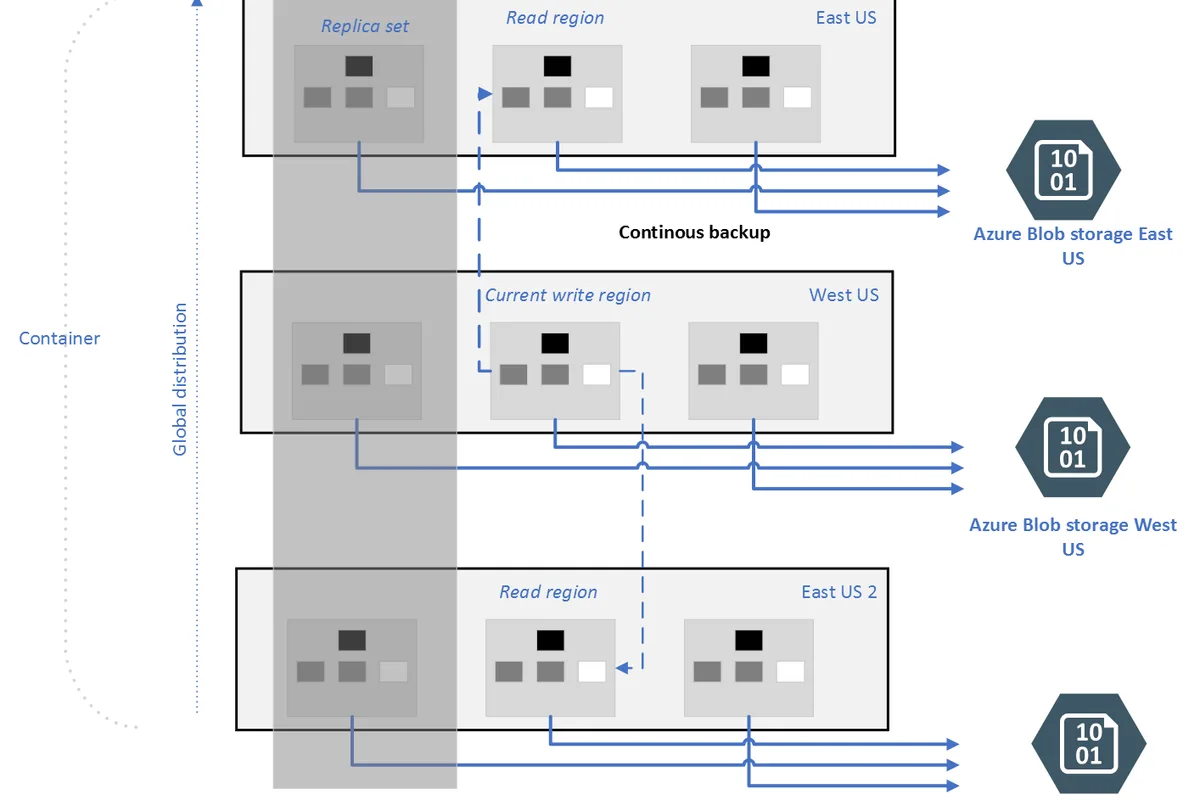
OpenAI explique que des métadonnées particulièrement sensibles à la latence, comme celles utilisées lors de l'authentification, peuvent être répliquées dans de nombreuses régions.
Certains comptes Azure Cosmos DB possèdent des répliques dans les 40 régions où l'entreprise sert du trafic.
D'autres utilisent une couverture géographique plus limitée, avec au moins une région par continent.
Cette approche réduit le délai entre les services applicatifs et les informations dont ils dépendent fréquemment.
Mais répliquer des volumes considérables partout serait coûteux et parfois impossible compte tenu des capacités physiques.
OpenAI réserve donc la réplication la plus large à des ensembles de données relativement petits et particulièrement importants.
Cette stratégie ne signifie pas que toutes les données des utilisateurs sont copiées dans toutes les régions.
La localisation dépend des besoins des applications, des contraintes techniques et des exigences applicables en matière de résidence des données.
Valkey et les caches distribués réduisent les allers-retours
La majorité des opérations de Habitat sont des lectures. OpenAI indique qu'elles représentent plus de 90 % des requêtes.
Une partie importante de ce trafic concerne un ensemble relativement réduit de données fréquemment demandées.
Cela rend l'infrastructure particulièrement adaptée à une stratégie de cache.
Habitat conserve certaines informations récemment consultées dans des serveurs Valkey proches des services qui traitent les requêtes.
Lorsqu'une donnée est déjà présente dans le cache, l'application peut éviter d'interroger directement le stockage distant.
Le gain est particulièrement intéressant lorsque la base principale se situe dans une autre région.
Mais le cache introduit un problème bien connu : conserver longtemps une donnée augmente les chances de la retrouver rapidement, tout en augmentant le risque qu'elle soit devenue obsolète.
À l'inverse, supprimer les données du cache trop fréquemment impose davantage de lectures auprès du stockage principal.
OpenAI a donc choisi de ne pas dépendre uniquement d'une durée d'expiration fixe.
Le Change Data Capture permet d'invalider les données modifiées
La plateforme utilise le flux de modifications d'Azure Cosmos DB pour détecter les changements effectués dans le stockage.
Lorsqu'une donnée change, des services internes propagent des opérations d'invalidation vers les caches concernés.
La prochaine requête portant sur cette donnée provoque alors une nouvelle lecture, permettant de récupérer sa version actualisée.
OpenAI indique que cette propagation mondiale se réalise en quelques secondes.
Cette approche cherche à préserver un taux élevé de réponses fournies par le cache, tout en limitant la durée pendant laquelle une information ancienne reste utilisée.
Le mécanisme de Change Data Capture ne sert pas uniquement à accélérer les lectures.
Il contribue également à alimenter des systèmes d'indexation, d'analyse et de circulation des données.
OpenAI mentionne plusieurs millions de modifications capturées chaque seconde, réparties notamment sur plus d'une centaine de topics Kafka.
Le système doit gérer les défaillances de travailleurs, les interruptions régionales et les erreurs de destination sans bloquer l'ensemble des flux.
La fiabilité repose notamment sur des mécanismes de reprise, de gestion des files d'attente et de répartition du travail.
Le passage de Python à Rust contribue à une baisse importante de la latence
La dernière amélioration importante concerne le langage utilisé pour exécuter une partie du service Habitat.
OpenAI explique avoir réécrit son service en Rust afin de réduire les surcoûts présents dans son implémentation Python.
Ce changement s'ajoute aux gains obtenus par la réplication ciblée des données et les caches distribués.
L'ensemble de ces optimisations aurait permis de faire passer la latence médiane mondiale des lectures d'environ 120 millisecondes à environ 10 millisecondes.
Il s'agit d'une amélioration d'un facteur 12 selon les mesures internes de l'entreprise.
Cette précision est importante : OpenAI mesure ici le temps des lectures effectuées par Habitat, et non le temps de génération d'une réponse complète par ChatGPT.
Un modèle d'IA peut encore nécessiter un temps de calcul substantiel, indépendamment de la vitesse d'accès à ses données applicatives.
De plus, la médiane ne décrit pas les requêtes les plus lentes.
Les accès à des informations absentes du cache peuvent toujours nécessiter une interrogation du stockage distant.
La progression annoncée témoigne néanmoins d'une optimisation importante sur une opération exécutée extrêmement fréquemment.
Un futur stockage interne à l'échelle de l'exaoctet
OpenAI ne considère pas cette architecture comme définitive.
L'entreprise annonce travailler sur un nouveau système interne capable de gérer des volumes de stockage à l'échelle de l'exaoctet.
Ce projet repose notamment sur RocksDB Cloud, technologie issue de Rockset, et sur une réplication fondée sur Raft.
Il reprend le modèle documentaire utilisé par Azure Cosmos DB, mais adopte une organisation différente du stockage physique.
L'objectif est notamment de réduire la quantité de mémoire flash nécessaire grâce à une architecture désagrégée et à la réplication physique.
OpenAI reconnaît un compromis : cette approche accepte un débit maximal de requêtes inférieur en échange d'une meilleure efficacité pour certaines catégories de données volumineuses.
Le projet est toujours en développement.
Il ne remplace pas aujourd'hui Azure Cosmos DB dans l'ensemble de Habitat, et l'entreprise n'a pas annoncé de calendrier public de migration généralisée.
Il montre cependant la direction envisagée pour accompagner une nouvelle phase de croissance du stockage.
L'échelle change les règles de l'ingénierie cloud
La publication du 23 octobre livre une conclusion moins spectaculaire qu'un nouveau modèle d'intelligence artificielle, mais probablement essentielle pour comprendre le fonctionnement de ChatGPT.
À grande échelle, augmenter simplement le nombre de serveurs ne suffit plus.
Il faut choisir quelles données répliquer, quelles opérations prioriser, comment isoler les charges, où placer les ressources et comment réagir lorsqu'une infrastructure régionale rencontre un problème.
La trajectoire de Habitat illustre aussi les limites des solutions universelles.
Un stockage entièrement mutualisé peut devenir vulnérable aux charges excessives. Une organisation entièrement isolée peut rendre la gestion des capacités trop complexe. La solution retenue par OpenAI combine mutualisation, régulation du trafic et coopération avec son fournisseur cloud.
La baisse de latence annoncée est notable, mais elle reste une mesure interne spécifique à la plateforme de stockage.
Ce qui ressort surtout de ce retour d'expérience, c'est que les performances visibles d'un service d'IA reposent sur une infrastructure beaucoup plus vaste que le modèle lui-même.
Avec plus de 500 pétaoctets administrés, Habitat rappelle une réalité simple : servir plus d'un milliard d'utilisateurs exige aussi une ingénierie des bases de données à une échelle exceptionnelle.