 Par Tsuky
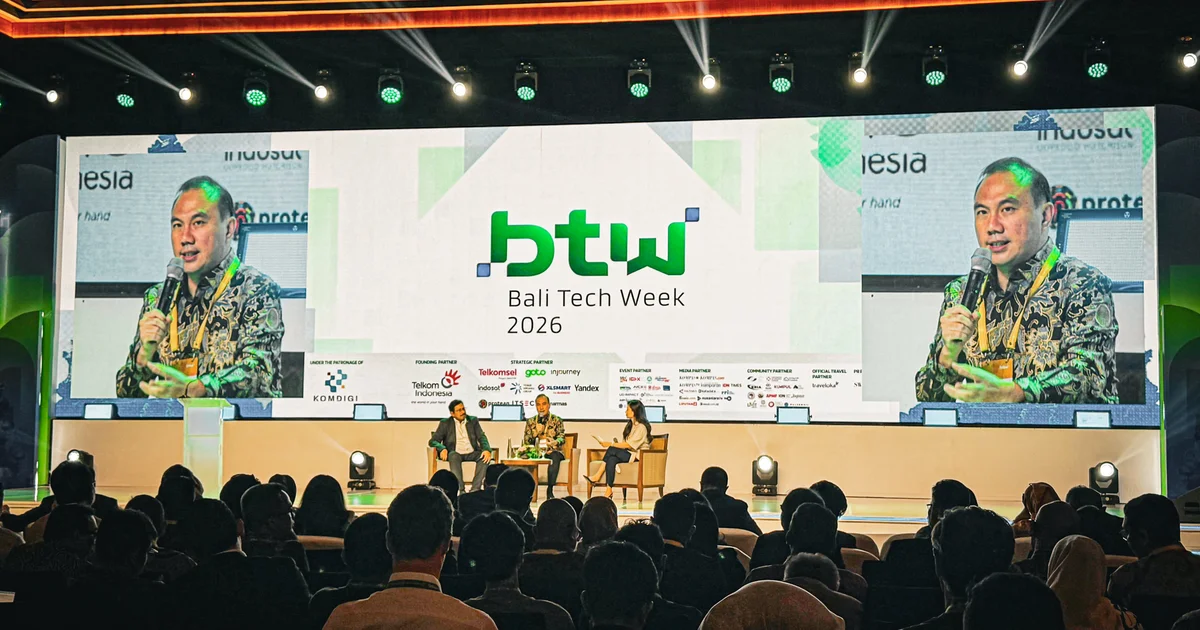
Demandez à une intelligence artificielle de rédiger un courrier en anglais : les résultats peuvent être convaincants. Demandez-lui de répondre dans une langue régionale moins représentée sur Internet, avec les expressions réellement utilisées dans une conversation quotidienne, et l'expérience devient parfois bien différente. C'est l'un des problèmes que GoTo veut résoudre. Le groupe technologique indonésien, connu notamment pour Gojek et son écosystème de services numériques, a présenté un nouveau modèle de langage à Bali Tech Week le 19 octobre 2026. Sa particularité ne réside pas uniquement dans ses 27 milliards de paramètres. Il a été adapté à des langues et à des contextes culturels que les plus grands modèles internationaux ne traitent pas nécessairement avec la même précision que l'anglais. GoTo cible l'indonésien, le javanais, le soundanais, le balinais et le batak. Surtout, l'entreprise a publié les poids du modèle sur Hugging Face. Ce n'est donc pas seulement une démonstration de salon. Des chercheurs, des universités et des entreprises peuvent désormais récupérer cette base technique pour développer leurs propres applications, sous réserve des conditions de licence applicables. L'annonce illustre une évolution importante du marché : la taille d'un modèle ne suffit pas à déterminer son utilité pour un public donné.
Un modèle pensé pour un pays aux nombreuses langues
L'Indonésie possède une langue nationale, le bahasa Indonesia, qui facilite les échanges entre habitants d'un vaste archipel. Mais elle possède également une grande diversité de langues régionales. Le javanais et le soundanais sont utilisés par d'importantes communautés. Le balinais appartient à un autre environnement culturel, tandis que les langues batak regroupent plusieurs variétés présentes notamment à Sumatra. Cette diversité pose un défi aux modèles d'intelligence artificielle. Les systèmes entraînés principalement sur les données les plus abondantes du Web peuvent produire des résultats inégaux lorsqu'on leur demande de comprendre des expressions locales. Le problème ne se limite pas à la traduction. Une conversation peut contenir des références culturelles, des habitudes commerciales ou des façons particulières de formuler une demande. Un assistant destiné à un commerçant doit comprendre ce que le client veut réellement dire. Un outil administratif doit éviter de déformer les informations communiquées par les citoyens. GoTo souhaite précisément améliorer cette adaptation. Le groupe estime que l'Indonésie ne doit pas se limiter à utiliser des technologies développées pour d'autres marchés. Elle doit pouvoir créer des applications correspondant à ses propres besoins.
GoTo publie les poids du modèle, pas seulement une API
L'une des informations les plus importantes du lancement concerne la disponibilité. Le modèle est publié sur Hugging Face sous l'identifiant GoToCompany/gemma3-27b-cpt-gotoai-v3-instruct. Cette publication permet aux organisations intéressées de récupérer les fichiers nécessaires à son utilisation. Elles peuvent ensuite préparer leur propre environnement d'exécution et adapter le modèle aux tâches qu'elles souhaitent réaliser. La différence avec un service accessible uniquement par abonnement est significative. Une entreprise utilisant exclusivement une API externe dépend des conditions d'accès, des tarifs et de la disponibilité du fournisseur. Avec des poids accessibles, certaines organisations peuvent choisir d'héberger elles-mêmes leur modèle. Elles conservent alors davantage de contrôle sur l'infrastructure et les données traitées. Cela ne signifie pas que l'utilisation devient automatiquement gratuite. Les serveurs, les GPU, l'électricité et la maintenance représentent des dépenses réelles. Mais cette possibilité réduit la nécessité de développer un grand modèle à partir de zéro. Pour une université ou une jeune entreprise indonésienne, disposer d'une base préentraînée constitue une ressource importante.
Derrière les 27 milliards de paramètres, la technologie Gemma 3 de Google
GoTo ne prétend pas avoir créé l'intégralité de ce modèle sans s'appuyer sur une technologie existante. Sa base est Gemma 3, une famille de modèles développée par Google. Les ingénieurs indonésiens ont poursuivi l'entraînement afin de mieux représenter certaines langues et certains usages locaux. Cette méthode permet de profiter des capacités générales du modèle initial tout en le spécialisant. Elle peut être particulièrement intéressante lorsqu'on possède des données de qualité sur une langue donnée, mais pas les moyens nécessaires pour construire un grand modèle entièrement nouveau. Il faut néanmoins préciser le sens de l'expression open source employée par GoTo. Les poids sont accessibles et le groupe annonce des possibilités d'utilisation et d'adaptation, notamment pour les entreprises. Mais le modèle dérive de Gemma et reste soumis à ses conditions de licence. Une publication gratuite de poids ne correspond pas nécessairement à une licence libre classique reconnue sans restrictions. Les développeurs doivent donc vérifier les conditions applicables avant toute distribution ou utilisation commerciale. Cette nuance juridique ne diminue pas l'intérêt de la publication. Elle permet simplement de comprendre exactement ce qui est proposé.
Un entraînement construit autour de textes indonésiens
Pour spécialiser le modèle, GoTo explique avoir utilisé des données textuelles provenant notamment de partenaires médias et de sites publics indonésiens. L'entreprise a également rassemblé des contenus en langues régionales. La collecte est un enjeu essentiel. Les modèles de langage apprennent des régularités à partir des exemples présents dans leurs données d'entraînement. Lorsqu'une langue est peu représentée, les résultats peuvent devenir moins fiables, surtout pour des formes d'expression locales. Selon les informations communiquées à The Business Times, l'entraînement supplémentaire a mobilisé environ 65 milliards de tokens. Une grande partie correspond à des contenus en indonésien. Le groupe mentionne également des données en anglais ainsi qu'un ensemble destiné aux langues régionales. Ces volumes constituent des indications sur le travail réalisé. Ils ne garantissent pas à eux seuls la qualité linguistique du modèle. Les choix de collecte, le nettoyage des données et l'évaluation des réponses ont une importance considérable. Un modèle entraîné sur beaucoup de textes répétitifs ou peu fiables ne devient pas automatiquement plus performant. La composition des données peut même influencer les erreurs et les biais qu'il reproduira.
L'université de Sumatra contribue à la représentation du batak
GoTo accorde une attention particulière aux données en batak. Pour cette partie du projet, l'entreprise a travaillé avec Universitas Sumatera Utara. L'objectif est de réunir des contenus correspondant aux usages contemporains de cette famille linguistique. Ce partenariat illustre une difficulté souvent négligée dans le développement des grands modèles. Les données disponibles sur Internet ne représentent pas toujours la façon dont une langue est réellement parlée aujourd'hui. Certains mots apparaissent surtout dans des dictionnaires ou des textes anciens. D'autres évoluent rapidement dans les conversations, les réseaux sociaux et les échanges commerciaux. La contribution d'institutions locales peut donc améliorer la pertinence des corpus. Elle peut également aider les équipes techniques à identifier des particularités qu'un traitement automatique généraliste manquerait. Mais l'annonce ne signifie pas que toutes les variétés du batak sont désormais maîtrisées. Il faudrait pour cela disposer d'évaluations détaillées, menées avec des locuteurs de différents territoires et contextes. Le partenariat constitue une étape importante dans la collecte de données. La qualité réelle des réponses devra être vérifiée langue par langue.
Un modèle plus petit peut-il dépasser son prédécesseur ?
GoTo avance un résultat intéressant : son nouveau modèle de 27 milliards de paramètres surpasserait, dans certaines évaluations linguistiques, une version antérieure de 70 milliards de paramètres. Ofir Shalev, responsable des données du groupe, a présenté cette comparaison à The Business Times. Selon lui, la nouvelle version obtient de meilleurs résultats globaux sur les langues indonésiennes évaluées. L'explication avancée tient notamment à un entraînement plus ciblé et à de meilleures données. Ce résultat est plausible sur le plan technique. Un modèle de grande taille n'est pas nécessairement le plus pertinent lorsqu'on lui demande d'accomplir une tâche très spécialisée. La qualité et la composition des données comptent également. Cependant, la comparaison doit être correctement interprétée. Il ne s'agit pas d'une démonstration de supériorité générale face à tous les modèles internationaux. Les résultats rapportés proviennent des évaluations présentées par GoTo. Le classement pourrait changer selon les tâches, les dialectes et les méthodes utilisées. Pour les développeurs intéressés, la bonne approche consistera à tester le modèle sur des exemples réels correspondant à leurs utilisateurs.
Un entraînement supplémentaire réalisé sur des GPU NVIDIA H200
The Business Times détaille également une partie des ressources mobilisées. D'après les informations fournies par GoTo, la poursuite d'entraînement a utilisé 64 GPU NVIDIA H200 pendant environ cinq jours. Une étape complémentaire d'adaptation aux instructions a demandé environ trois jours. Ces chiffres permettent de situer l'effort technique consacré à cette version. Ils ne représentent toutefois pas le coût total de développement. Le modèle initial Gemma 3 avait déjà été entraîné par Google. GoTo a également dû rassembler des données, les préparer, les vérifier et concevoir des évaluations. Les durées annoncées ne couvrent donc pas nécessairement tout le travail humain et informatique nécessaire. Pour les petites organisations, l'intérêt du projet réside justement dans cette mutualisation. Elles n'ont pas besoin de reproduire l'entraînement initial d'un modèle de plusieurs dizaines de milliards de paramètres. Elles peuvent partir d'un système existant et concentrer leurs ressources sur les usages auxquels elles veulent répondre. Cette logique pourrait favoriser des projets locaux impossibles à financer autrement.
27 milliards de paramètres ne signifie pas un modèle utilisable sur tous les ordinateurs
GoTo insiste sur la possibilité d'exécuter cette IA sur une infrastructure moins importante que celle requise par certains modèles beaucoup plus grands. Selon les informations rapportées par The Business Times, une configuration non quantifiée pourrait nécessiter environ 55 à 65 Go de mémoire GPU. Le groupe évoque notamment une carte NVIDIA A100 équipée de 80 Go. Ce type d'accélérateur reste un matériel professionnel coûteux. Le modèle n'est donc pas destiné à fonctionner confortablement sur n'importe quel ordinateur portable. Des techniques de quantification peuvent réduire la mémoire nécessaire. Elles consistent à représenter certains paramètres avec moins de précision numérique. Cela permet parfois d'utiliser des GPU moins puissants, avec d'éventuels compromis sur la qualité ou les performances. Le résultat dépend de la méthode choisie. Il faut également prendre en compte la longueur des conversations et le nombre d'utilisateurs simultanés. Un modèle qui fonctionne pour un seul chercheur ne peut pas nécessairement servir immédiatement des milliers de personnes. Le vrai avantage réside dans la possibilité offerte à des structures disposant de moyens raisonnables d'envisager un hébergement autonome.
Des applications concrètes pour les commerçants et les services publics
La publication du modèle ne constitue pas uniquement une initiative scientifique. GoTo possède déjà des activités dans lesquelles la compréhension de la langue locale joue un rôle direct. Le groupe exploite des services de transport, de livraison et des outils destinés aux commerçants. Dans un entretien accordé à The Business Times, Ofir Shalev explique que certaines technologies développées par GoTo servent à lire des photographies de menus. L'objectif peut être d'aider un restaurant à créer plus facilement une fiche de produits dans GoFood. D'autres fonctions participent au traitement des réclamations, notamment lorsqu'un client transmet une photographie. Ces exemples montrent comment des modèles linguistiques ou multimodaux peuvent s'intégrer à des tâches commerciales quotidiennes. Il faut toutefois distinguer le modèle publié le 19 octobre de tous les systèmes actuellement déployés par GoTo. L'entreprise précise que certaines fonctions utilisent déjà des modèles plus récents ou différents. Le nouveau modèle public représente donc une base technique accessible, et non une description exhaustive de toutes les technologies internes du groupe. Les usages possibles restent nombreux : recherche documentaire, assistants administratifs, traduction et outils éducatifs.
Une démarche de souveraineté numérique qui conserve des dépendances internationales
GoTo rattache son annonce à l'ambition indonésienne de renforcer ses capacités numériques. Le groupe évoque notamment la vision nationale Indonesia Digital Vision 2045. Son directeur général, Hans Patuwo, estime que le pays ne doit pas rester uniquement utilisateur de technologies étrangères. Il souhaite encourager la création d'applications adaptées à la population locale. Cette stratégie peut contribuer à développer des compétences et un écosystème d'entreprises spécialisées. Mais la notion de souveraineté mérite d'être examinée avec précision. Le modèle repose sur Gemma 3, conçu par Google. Son entraînement supplémentaire utilise des GPU NVIDIA. La distribution passe par Hugging Face, une plateforme internationale. Il ne s'agit donc pas d'une indépendance complète à l'égard des technologies étrangères. L'avancée concerne plutôt la possibilité de maîtriser une part croissante de l'adaptation, des données et des usages. Une organisation indonésienne peut récupérer les poids et les héberger sur une infrastructure de son choix. Cela représente déjà un degré de contrôle différent d'un service accessible uniquement par une API externe.
Les universités participent aussi à la construction de l'écosystème
Le projet ne repose pas seulement sur les ingénieurs permanents de GoTo. L'entreprise explique avoir travaillé avec des stagiaires provenant de sept universités indonésiennes. Ces participants ont contribué à plusieurs étapes. La préparation des données et les évaluations figurent parmi les tâches citées. Certains ont également participé à la collecte de contenus en langues régionales. D'autres ont prêté leur voix à des travaux liés aux technologies vocales du groupe. Cette dimension de formation est importante. Développer des modèles d'IA exige des compétences qui dépassent la seule programmation. Il faut comprendre les données, leurs biais, les méthodes d'évaluation et les contraintes de déploiement. Les langues régionales demandent aussi des connaissances linguistiques et culturelles. En impliquant des étudiants et des établissements locaux, GoTo cherche à élargir le nombre de personnes capables de travailler sur ces technologies. Les résultats à long terme dépendront néanmoins de la continuité des programmes et des ressources disponibles. La publication d'un modèle constitue une étape. La création d'un écosystème durable nécessite des compétences, des infrastructures et des usages économiquement viables.
Les limites : erreurs, dialectes et confidentialité
Un modèle spécialisé peut améliorer l'expérience sans faire disparaître les limites habituelles des intelligences artificielles génératives. Il peut produire des réponses incorrectes. Il peut inventer une référence, mal interpréter un contexte ou confondre différentes variétés linguistiques. La qualité peut également varier d'un sujet à l'autre. Un bon résultat pour une conversation courante n'est pas une garantie pour une question juridique ou médicale. Les organisations qui souhaitent adopter le modèle doivent donc préparer leurs propres évaluations. Il faudra notamment tester les langues et les expressions réellement utilisées par leurs publics. La confidentialité représente un deuxième enjeu. Un modèle hébergé localement offre davantage de possibilités de contrôler la circulation des données. Mais cette architecture exige des mesures de sécurité et une gestion correcte des accès. Télécharger des poids sur Hugging Face ne suffit pas à garantir que toutes les données traitées seront protégées. Enfin, les conditions de licence doivent être examinées avant la mise en production d'un service commercial. L'accessibilité technique et la liberté juridique ne sont pas exactement la même chose.
L'avenir de l'IA ne se jouera pas uniquement en anglais
La publication de GoTo illustre une direction importante pour le secteur. Les modèles mondiaux cherchent à répondre à un nombre croissant de questions et de tâches. Mais leur qualité peut rester inégale lorsque les données d'entraînement représentent mal certaines langues ou cultures. Une approche plus locale peut apporter une réponse. En partant d'une base technique existante et en l'adaptant à un environnement linguistique précis, il devient possible de construire des systèmes plus pertinents pour une population donnée. C'est ce que GoTo cherche à démontrer avec ses 27 milliards de paramètres. L'entreprise annonce des gains face à son ancien modèle plus grand. Elle publie effectivement les poids. Elle implique des universités et souhaite encourager la création de services indonésiens. Ces éléments sont concrets. La supériorité du modèle dans tous les usages reste cependant à démontrer indépendamment. Les prochains tests devront surtout déterminer s'il comprend correctement les différentes langues régionales et s'il apporte des bénéfices mesurables aux utilisateurs. Le succès du projet ne dépendra pas seulement du nombre de téléchargements. Il dépendra du nombre d'applications réellement utiles qui pourront être développées à partir de cette base. Avec cette annonce, GoTo rappelle une évidence parfois oubliée dans la course aux modèles géants : une intelligence artificielle devient véritablement intéressante lorsqu'elle comprend les personnes auxquelles elle s'adresse.